WhisperAPI – Transcrição de Áudio para Texto Privada e Flexível
Visão Geral
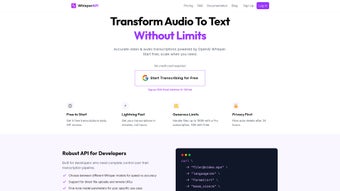
O WhisperAPI é um serviço de transcrição voltado para desenvolvedores que aproveita o poder do modelo Whisper da OpenAI para transformar qualquer arquivo de áudio ou vídeo em texto preciso e pesquisável. Seja você construindo uma plataforma de indexação de podcasts, uma pipeline de análise de suporte ao cliente ou um dashboard de transcrição sem código, o WhisperAPI oferece flexibilidade, velocidade e privacidade de dados em um único pacote de API. O serviço suporta uma ampla gama de formatos de mídia — MP3, WAV, MP4, MOV e mais — enquanto reconhece dezenas de idiomas com alta fidelidade.
Uma camada gratuita de início permite testar o sistema sem compromisso, e planos escaláveis atendem perfeitamente a empresas de alto volume. Ao excluir automaticamente os arquivos enviados após 24 horas, o WhisperAPI garante confidencialidade para gravações sensíveis, tornando-se uma escolha confiável para empresas que valorizam segurança tanto quanto velocidade. Além da transcrição bruta, a plataforma fornece saída com timestamps, marcadores de diarização de falantes e pontuações de confiança, permitindo que desenvolvedores criem experiências ricas e interativas, como bibliotecas de vídeos pesquisáveis, legendagem em tempo real e resumos de conteúdo impulsionados por IA.
A API é construída sobre uma infraestrutura em nuvem distribuída globalmente, o que significa respostas com baixa latência para usuários na América do Norte, Europa e Ásia-Pacífico. Para equipes que precisam cumprir GDPR, CCPA ou HIPAA, o WhisperAPI oferece logs de auditoria opcionais e políticas personalizadas de retenção de dados, reforçando sua posição como uma solução de transcrição pronta para conformidade. Em suma, o WhisperAPI combina a precisão de ponta do Whisper com uma experiência de desenvolvedor cuidadosamente projetada, tornando-se uma opção convincente para quem precisa converter fala em texto em larga escala.
Recursos e Capacidades Principais
- Flexibilidade na Escolha do Modelo: Escolha entre os modelos tiny, base, small, medium ou large do Whisper para equilibrar velocidade e precisão da transcrição. O modelo tiny processa trechos curtos em segundos, enquanto o modelo large oferece qualidade próxima à humana para gravações complexas com múltiplos falantes.
- Suporte a Múltiplos Formatos: Aceita mais de 30 codecs de áudio e vídeo, incluindo MP3, AAC, WAV, FLAC, MP4, AVI, WebM e até containers menos comuns como OGG e AIFF, garantindo que você nunca precise converter arquivos antes de enviar.
- Cobertura de Idiomas: Reconhecimento nativo para mais de 30 idiomas e dialetos principais, com detecção automática de idioma que reduz o tempo de configuração em projetos multilíngues e suporta troca de códigos dentro do mesmo arquivo.
- Ajuste de Parâmetros: Ajuste a temperatura, o tamanho do feixe e as opções de timestamps para personalizar a saída para legendas, transcrições pesquisáveis ou captura literal, dando controle granular sobre o equilíbrio entre criatividade e precisão.
- Dashboard Sem Código: Uma interface web permite que usuários não técnicos enviarem arquivos por arrastar e soltar ou colar URLs remotas para transcrição instantânea, com modo de pré-visualização e exportação em um clique para formatos TXT, SRT, VTT ou JSON.
- Tratamento Seguro de Dados: Arquivos são armazenados criptografados (AES-256) e automaticamente apagados após 24 horas, cumprindo padrões GDPR, CCPA e ISO-27001, enquanto os dados em trânsito são protegidos pelo TLS 1.3.
- Precificação Escalável: O plano gratuito inclui 30 minutos de transcrição por mês; planos pagos desbloqueiam limites mais altos, processamento prioritário, suporte dedicado e a possibilidade de negociar contratos empresariais com descontos por volume.
- Webhooks em Tempo Real: Receba resultados de transcrição via callbacks HTTP, permitindo integração perfeita em pipelines CI, sistemas de gerenciamento de conteúdo ou serviços de notificação personalizados sem necessidade de polling.
- Documentação Extensiva: Especificações OpenAPI compatíveis com Swagger, trechos de código para Python, Node.js, Java, Go e Ruby, além de projetos de exemplo no GitHub que demonstram boas práticas de processamento em lote, streaming e tratamento de erros.
- Analytics de Uso: Métricas do painel mostram tempo de processamento, contagem de palavras, custo por solicitação e métricas de desempenho específicas por modelo, ajudando a otimizar orçamentos e prever despesas futuras.
Guia de Instalação, Integração e Uso
Começar com o WhisperAPI é simples, seja por meio de uma abordagem por linha de comando, um SDK completo ou o painel visual sem código. Os seguintes passos guiam você pela criação de conta, configuração do ambiente, envio da primeira solicitação de transcrição e uso de recursos avançados como webhooks e monitoramento de uso.
1. Inscrição e Obtenção da Chave de API
Acesse o site do WhisperAPI, crie uma conta gratuita e navegue até a seção Chaves de API. Após confirmar seu e-mail, clique em “Gerar Nova Chave”. Copie a chave gerada; você precisará dela no cabeçalho Authorization de cada solicitação. Para maior segurança, pode restringir a chave a faixas IP específicas ou ativar segredos rotativos diretamente no console.
2. Escolha do Ambiente Preferido
A API é independente de plataforma — qualquer sistema capaz de fazer chamadas HTTPS (Windows, macOS, Linux, Android, iOS) funciona. Para integração do lado do servidor, instale os SDKs oficiais:
pip install whisperapi(Python) – inclui funções auxiliares para uploads multipart e lógica automática de repetição.npm install @whisperapi/client(Node.js) – suporta uploads em streaming e integra-se bem com back-ends Express ou Next.js.- Baixe o JAR do Java no Maven Central – ideal para aplicativos Android ou serviços empresariais Java.
- Para desenvolvedores .NET, um pacote NuGet
WhisperApi.SDKestá disponível, oferecendo métodos assíncronos e modelos de resposta fortemente tipados.
3. Solicitação Básica de Transcrição (Exemplo cURL)
curl -X POST https://api.whisperapi.com/v1/transcribe \
  -H "Authorization: Bearer SUA_CHAVE_DE_API" \
  -F "file=@/caminho/para/audio.mp3" \
  -F "model=medium" \
  -F "language=en" \
  -F "timestamps=true"
Essa chamada retorna um payload JSON contendo a transcrição completa, timestamps por palavra, pontuações de confiança e um bloco opcional de diarização de falantes, se habilitado. Erros são reportados com códigos HTTP padrão e um campo detalhado error.message para facilitar o depuração.
4. Uso do Painel Sem Código
Faça login no portal do WhisperAPI, clique em Nova Transcrição, arraste seu arquivo ou cole uma URL pública, selecione o modelo desejado e clique em Iniciar. Os resultados aparecem em minutos e podem ser baixados como texto simples, SRT, VTT ou arquivos JSON. A interface também oferece o modo “Pré-visualização em Tempo Real” que destaca cada palavra conforme é reconhecida, útil para demonstrações de legendagem em tempo real.
5. Tratamento de Webhooks
Registre uma URL de webhook nas configurações da sua conta. O WhisperAPI enviará o transcripto concluído para esse endpoint via POST, incluindo uma assinatura de verificação que você pode validar usando sua chave secreta. Esse mecanismo permite armazenar automaticamente transcrições em um banco de dados, acionar pipelines NLP downstream ou enviar notificações para Slack ou Microsoft Teams.
6. Gestão de Uso e Faturamento
O painel fornece um medidor de uso em tempo real que se atualiza instantaneamente. Se você se aproximar do limite do seu plano, pode atualizar instantaneamente, habilitar notificações de “limite suave” ou configurar recargas automáticas via cartão de crédito salvo. Faturas detalhadas estão disponíveis para exportação em formato CSV ou PDF, simplificando o controle de despesas para equipes financeiras.
Em resumo, a documentação clara, os SDKs prontos e a interface intuitiva reduzem o tempo de integração de dias para horas, permitindo que você se concentre em construir funcionalidades que agreguem valor, em vez de lutar contra o processamento de áudio.
Vantagens e Desvantagens, Perguntas Frequentes e Veredito Final
Vantagens
- Alta precisão em múltiplos idiomas graças ao Whisper da OpenAI.
- Escolha flexível de modelos equilibra custo e velocidade para qualquer carga de trabalho.
- Segurança robusta com exclusão automática de arquivos após 24 horas, criptografia em repouso e TLS 1.3 em trânsito.
- SDKs e documentação completas para integração rápida em Python, Node.js, Java, .NET e Go.
- Plano gratuito de início permite testes sem risco e prototipagem rápida.
- Callbacks em tempo real via webhooks otimizam fluxos automatizados.
- Analytics detalhados de uso ajudam a otimizar orçamentos e prever despesas.
- Conformidade com GDPR, CCPA e ISO-27001 para tranquilidade empresarial.
Desvantagens
- Modelos grandes exigem mais recursos computacionais, gerando latência mais alta no plano gratuito.
- Não há implantação local; todo processamento é baseado em nuvem, o que pode ser um ponto de preocupação para dados extremamente sensíveis.
- Parâmetros avançados de ajuste podem ser intimidadores para iniciantes absolutos sem experiência prévia com APIs.
- O limite de tamanho de arquivo de 500 MB exige dividir gravações muito longas antes do envio.
- Os tempos de resposta do suporte para usuários do plano gratuito são mais longos do que para clientes empresariais pagos.
Perguntas Frequentes
Quão seguro é meu áudio enviado?
Os arquivos são criptografados em trânsito (TLS) e em repouso (AES-256). O WhisperAPI exclui automaticamente todos os arquivos após 24 horas, garantindo que não permaneçam cópias no servidor. Logs de auditoria opcionais permitem verificar os timestamps de exclusão.
Posso usar o WhisperAPI em aplicativos móveis?
Sim. A API funciona com qualquer plataforma capaz de enviar solicitações HTTPS, incluindo iOS (Swift) e Android (Kotlin/Java). Use os pontos finais REST diretamente ou o SDK JavaScript leve para React Native para incorporar capacidades de transcrição em experiências móveis.
Qual é o modelo de precificação após o plano gratuito?
O WhisperAPI cobra por minuto de áudio processado. Os preços variam conforme o tamanho do modelo: o modelo “tiny” custa US$0,003/min, o modelo “base” US$0,006/min, o modelo “small” US$0,009/min, o modelo “medium” US$0,012/min e o modelo “large” US$0,018/min. Descontos por volume e contratos anuais estão disponíveis para clientes empresariais.
Preciso especificar o idioma da gravação?
A detecção de idioma é automática, mas você pode melhorar a precisão definindo explicitamente o parâmetro language, especialmente em trechos curtos, ambientes ruidosos ou gravações com múltiplos dialetos.
Existe um limite de tamanho de arquivo?
A API aceita arquivos até 500 MB. Mídias maiores devem ser divididas em partes antes do envio para permanecer dentro do limite e reduzir a latência. Os SDKs fornecem utilitários auxiliares para divisão e submissão paralela.
Veredito Final e Chamada para Ação
O WhisperAPI oferece uma combinação convincente de precisão, flexibilidade e segurança que poucos serviços de transcrição igualam. Sua precificação em camadas e plano gratuito generoso tornam-no acessível a entusiastas, enquanto seus recursos empresariais — como callbacks via webhooks, analytics detalhados e tratamento de dados conforme GDPR — atraem grandes organizações. Se você precisa de uma solução confiável e nativa em nuvem para converter áudio ou vídeo em texto pesquisável, o WhisperAPI é um investimento inteligente. Baixe o WhisperAPI hoje, comece com o plano gratuito e experimente transcrição sem esforço em minutos.